

Selbst ausprobieren
Aus einem Winkel wird Bewegung.
Bewege ein Gelenk und beobachte die Position des Greifers.
Was du beobachten kannst
Wenn ein Gelenk dreht, verändert sich die Position des Greifers. Mehrere Gelenke wirken beim echten Arm zusammen.
Ein Griff, den du vormachst
Ein kleiner Gegenstand liegt auf dem Tisch. Du führst einen Roboterarm zum Objekt, schliesst den Greifer und legst es in eine Schale. Der zweite Arm folgt deiner Bewegung. So beginnt beim SO-101 der Weg vom selbst gebauten Mechanismus zum lernenden Roboter.
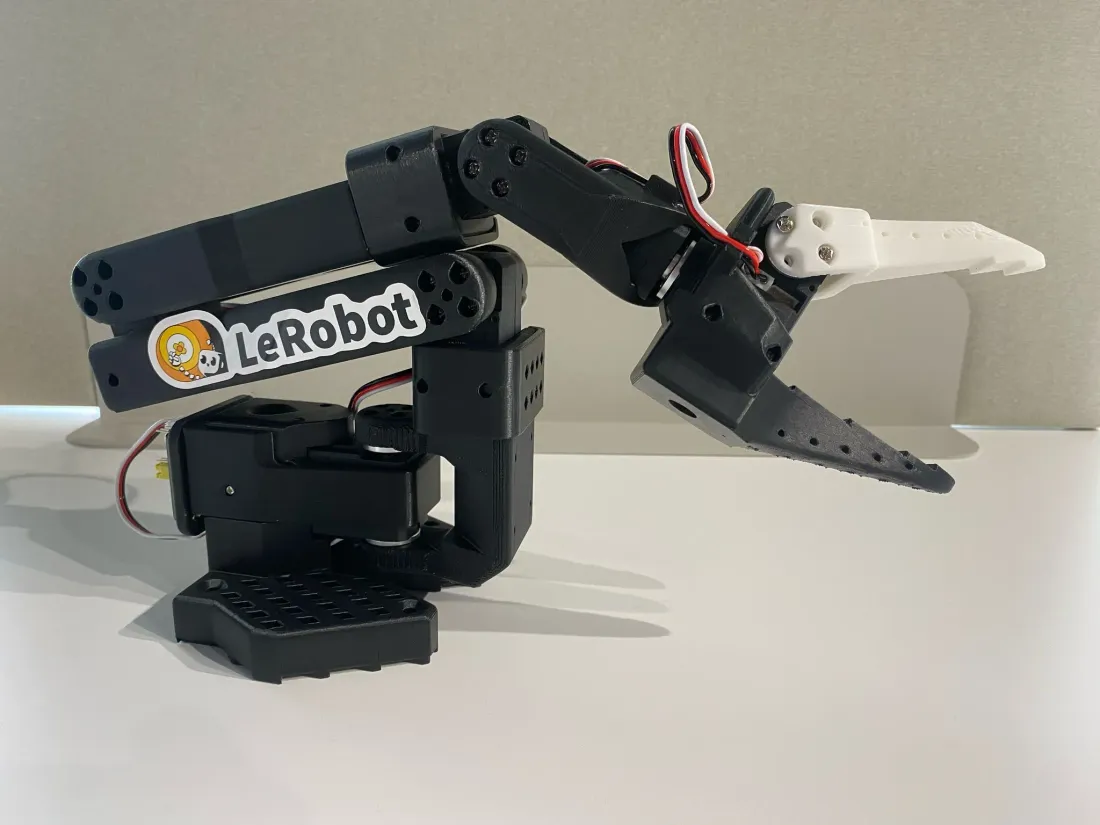
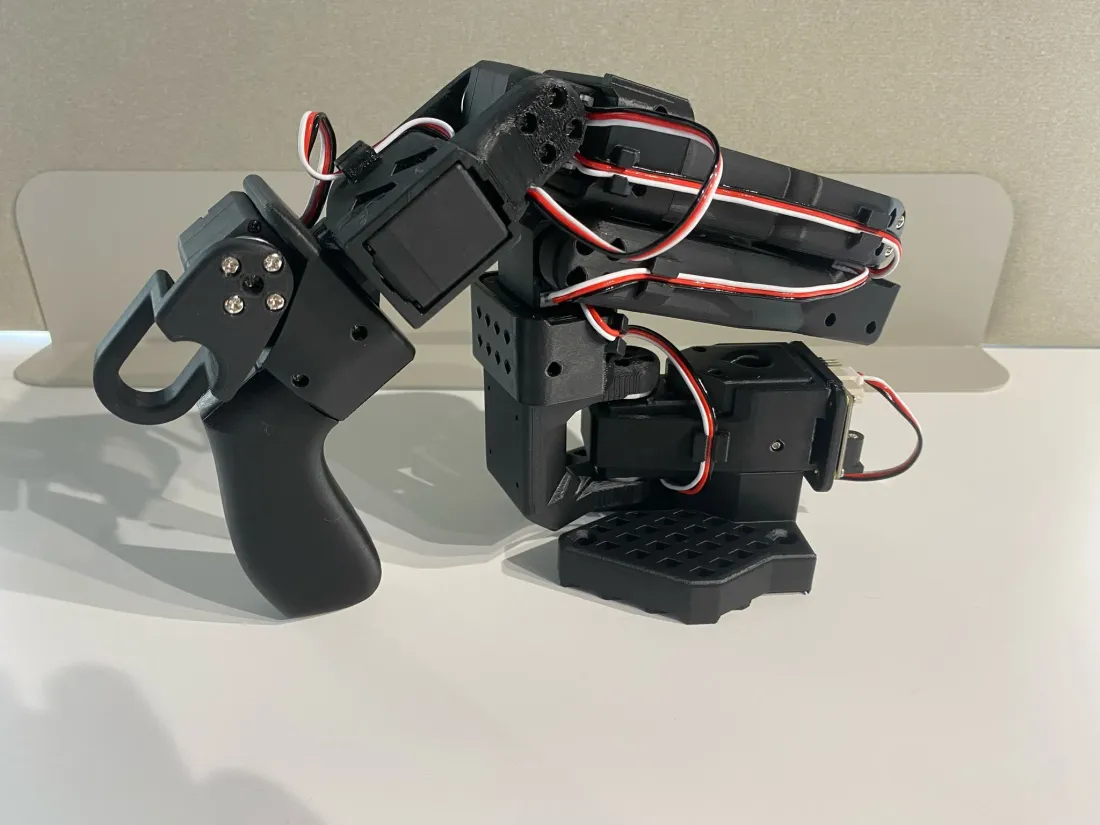
Der SO-101 stammt von The Robot Studio in Zusammenarbeit mit Hugging Face. Die gedruckten Bauteile halten Motoren, Gelenke und Greifer zusammen; LeRobot verbindet die Hardware mit Werkzeugen für Datensammlung und maschinelles Lernen. Unser LunoLabs-Aufbau besteht aus zwei selbst aufgebauten Armen. Die Fotos aus dem Originalprojekt zeigen zusätzlich, wie sich Führungs- und Folgearm unterscheiden. Originalprojekt und Bauteile
So wird aus einer Bewegung ein Lernbeispiel
- Vormachen: Du bewegst den Führungsarm von Hand. Der Folgearm übernimmt die entsprechenden Gelenkstellungen. Vorher werden beide Arme aufgebaut und kalibriert. Aufbau und Kalibrierung
- Aufnehmen: Kamerabilder, Gelenkzustände und ausgeführte Aktionen bilden gemeinsam ein Lernbeispiel. Wiederhole eine überschaubare Aufgabe und kontrolliere, ob die Kamera Objekt und Greifer gut erfasst.
- Trainieren: Eine Steuerungsstrategie, die sogenannte Policy, lernt aus den aufgezeichneten Beispielen. LeRobot bietet dafür unter anderem ACT. Das Modell lernt Zusammenhänge zwischen Beobachtung und Bewegung.
- Ausprobieren: Die trainierte Policy erzeugt Aktionen für den Folgearm. Prüfe zunächst dieselbe Aufgabe und verändere anschliessend einzelne Bedingungen. Ein erfolgreicher Versuch sagt noch wenig über andere Objekte oder Kamerawinkel aus. Der LeRobot-Lernablauf
Wo kommen visuelle Modelle ins Spiel?
Ein visuelles Sprachmodell kann Bildinhalte mit Sprache verbinden. Für Roboteraktionen geht beispielsweise SmolVLA weiter: Kamerabilder, Roboterzustand und ein sprachlicher Auftrag werden gemeinsam genutzt, um Bewegungsfolgen zu erzeugen. Diese Verbindung heisst Vision-Language-Action, kurz VLA. Sie benötigt passende Daten und eine Prüfung am eigenen Aufbau. SmolVLA erklärt
Dein erster kleiner Versuch
Vergleiche auf den Bildern zuerst den Griff am Führungsarm mit dem Greifer am Folgearm. Nach Aufbau und Kalibrierung kannst du einen leichten Gegenstand per Handsteuerung in eine Schale legen. Kontrolliere dabei den Kamerablick: Bleibt der Gegenstand während des gesamten Griffs sichtbar? Das ist eine konkrete Frage für deinen nächsten Besuch beim Tech-Treff.
Von anderen Makern lernen
Schau dir an, wie es geht.
Train AI Robots Without Writing Code! (Introducing LeLab)
Achte ab 1:21 auf den Wechsel vom Vormachen zur Datensammlung. Was wird gespeichert, bevor das Training beginnt?
SO-101 Robot Arm — Autonomous Pick-and-Place (ACT Imitation Learning)
Verfolge Greifer und Objekt: Welche Zwischenbewegungen liegen zwischen Greifen und Ablegen?