Bilder verstehen
Was passiert zwischen Foto und Antwort? Verfolge Pixel, Bildmerkmale und Sprache durch ein VLM – und finde heraus, was es dabei wirklich lernt.
Vom Foto zur Antwort
Du siehst einen Roboterarm auf einer Werkbank und erkennst sofort Zusammenhänge. Ein Vision Language Model, kurz VLM, bekommt zunächst Farbwerte und deine Frage. Es muss Bildinformationen in eine Form bringen, die sein Sprachmodell verarbeiten kann.
Wir verfolgen diesen Weg an LLaVA-1.5-7B, einem offen dokumentierten Modell von 2023. Die folgenden Grössen gehören zu diesem Beispiel. Danach kannst du erklären, warum ein Bildraster noch keine Objekterkennung ist, was Bild und Sprache verbindet und weshalb eine neue Frage kein Training auslöst.
Verfolge ein Foto durch LLaVA-1.5.
Wir öffnen ein konkretes Architekturbeispiel von 2023. Neuere VLMs können andere Encoder, Auflösungen und Verbindungen verwenden.
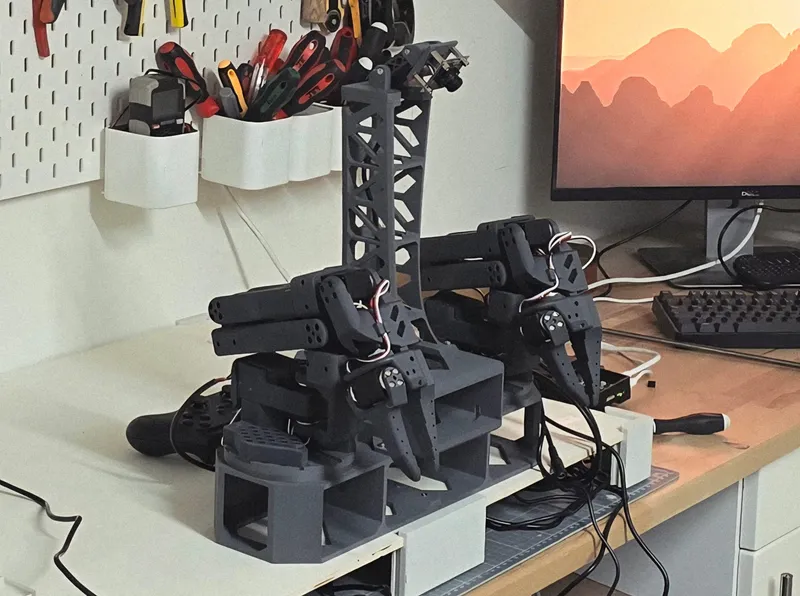
Ein Bildbereich enthält 14 × 14 Pixel mit je drei Farbwerten.
Aus Pixeln wird eine feste Eingabe
Das Foto wird zunächst quadratisch aufgefüllt und auf 336 × 336 Pixel gebracht. Die Pixelwerte werden nach den Vorgaben des Bildprozessors normalisiert. Ein Text-Tokenizer zerlegt parallel deine Frage in Text-Token. Das sind zwei verschiedene Vorbereitungen.
Ein Patch ist ein Bildbereich, kein erkanntes Objekt
14 × 14 Pixel ergeben einen Patch. 24 × 24 Patches ergeben hier 576 Positionen. Eine gelernte Abbildung und Transformer-Schichten erzeugen je 1024 Merkmalswerte. Self-Attention verbindet Informationen zwischen den Positionen: Auch der Vektor eines Greifer-Patches kann Kontext aus dem restlichen Bild enthalten.
Der Projektor macht Merkmale für das Sprachmodell nutzbar
Ein kleines neuronales Netz bildet jeden 1024-dimensionalen Bildvektor auf die 4096 Dimensionen des Sprachmodells ab. Diese Bildvektoren werden zusammen mit den Text-Einbettungen der Frage verarbeitet. Es entsteht dabei noch keine fertige Bildbeschreibung.
Die Antwort wächst Token für Token
Das Sprachmodell berechnet eine Verteilung über mögliche nächste Text-Token. Ein gewähltes Token ergänzt den Kontext, dann folgt der nächste Schritt. Training hat die Gewichte vorbereitet; bei einer normalen Antwort werden sie nicht weitertrainiert. Eine neue Frage ändert den Kontext und damit die mögliche Antwort.
Bildwerte
336 × 336 × 3Höhe × Breite × Farbkanäle. Das sind Eingabewerte, noch keine erkannten Gegenstände.
„Roboterarme, Kabel und Werkzeuge sind sichtbar.“
Alle vier Schritte sind unten lesbar. Mit JavaScript kannst du sie einzeln untersuchen.
Die Markierung zeigt deine Auswahl, keine Attention- oder Erklärbarkeitskarte. Wir berechnen hier keine 7-Milliarden-Parameter-Inferenz. Die Architekturgrössen stammen aus dem Originalmodell; der Ablauf aus dem Originalcode.
Probiere es aus: Gehe zum zweiten Schritt. Wähle zuerst einen Bereich mit Werkbank, dann einen mit einem Teil des Arms. Der vergrösserte Ausschnitt und seine Farbwerte ändern sich. Die Anzahl der Bildpositionen bleibt gleich. Beides folgt direkt aus der festen Aufbereitung auf 336 × 336 Pixel.
Wie aus Pixeln Merkmale werden
Ein 14 × 14 grosser Patch enthält 196 Pixel mit je drei Farbkanälen, also 588 Farbwerte. Eine gelernte Abbildung macht daraus einen Vektor. Ein Vektor ist zunächst einfach eine geordnete Liste von Zahlen. Als Embedding beschreibt er einen Inhalt in einem Zahlenraum, mit dem das weitere Netz rechnen kann.
Zusätzliche Positionsinformationen erhalten die räumliche Anordnung. In den Transformer-Schichten kann jede Position Informationen anderer Positionen einbeziehen. Self-Attention berechnet dafür aus den aktuellen Merkmalen Abfragen, Schlüssel und Werte: Wie gut Abfrage und Schlüssel zusammenpassen, bestimmt die Gewichtung der Werte. Das geschieht in mehreren Schichten und Köpfen. Es ist eine gelernte Rechenoperation, kein menschlicher Blick.
So kann ein Merkmal an der Position eines Greifers auch Informationen über den restlichen Arm enthalten. Eine einzelne Zahl hat dabei keine von uns vorgegebene Bedeutung wie «Greifer erkannt». LLaVA übernimmt in dieser Konfiguration 576 solcher kontextabhängigen Vektoren mit je 1024 Werten. Der zusätzliche CLS-Token des Encoders wird dabei weggelassen. Das ist im Vision-Tower und seiner Merkmalsauswahl nachvollziehbar.
Du verschiebst den Arm auf dem Foto. Was ändert sich?
Erklärung ansehen
Bei 336 × 336 Pixeln und 14 × 14 grossen Patches bleiben es 576 Positionen. Diese sind keine Liste erkannter Gegenstände.
Wie das Sprachmodell die Bildmerkmale nutzt
Das Sprachmodell erwartet hier Eingabevektoren mit 4096 Werten. Ein Projektor verbindet die beiden Formate: ein kleines neuronales Netz mit zwei linearen Abbildungen und einer GELU-Aktivierung dazwischen. Aus 576 × 1024 wird 576 × 4096. Die Bildpositionen bleiben erhalten; die Vektoren werden breiter. Seine Gewichte müssen lernen, welche Abbildung für die Sprachaufgabe nützlich ist. Projektor im Originalcode
Die projizierten Bildmerkmale werden an der Bildmarkierung in die Eingabefolge des Sprachmodells eingesetzt. Dazu kommen die Einbettungen der Frage. Text-Token können Wörter, Wortteile oder Satzzeichen sein. Das Modell berechnet aus diesem Kontext mögliche nächste Token. Ein ausgewähltes Token kommt zur Antwort hinzu, dann geht die Berechnung weiter. Zusammenbau der Eingabe
Die Frage «Welche Gegenstände sind sichtbar?» lenkt die Antwort anders als «Funktioniert der Roboter?». Sichtbare Gegenstände lassen sich am Foto prüfen. Ob Motoren, Software und Stromversorgung funktionieren, zeigt ein einzelnes Standbild nicht zuverlässig. Eine flüssige Antwort kann trotzdem mehr behaupten, als das Bild belegt.
Was Sehen mit Lernen und Handeln verbindet
Bei einer normalen Anfrage verwendet das Modell bereits gelernte Gewichte. Inferenz heisst: mit diesen Gewichten eine Ausgabe berechnen. Erst eine Trainingsschleife mit Lernziel, Fehlerberechnung und Updates verändert sie. Wie das zahlenmässig funktioniert, probierst du im nächsten Teil selbst aus.
Für dein Projekt lohnt sich zuerst ein klares Ausgabeziel:
| Du brauchst … | Passender Ausgangspunkt |
|---|---|
| Schrift vom Etikett als Text | OCR; auch ein VLM kann diese Aufgabe bearbeiten |
| Objektklassen und Bildbereiche | Einen Objektdetektor, etwa DETR |
| Antworten auf unterschiedliche Bildfragen | Ein VLM |
| Bewegungen des SO-101 | Eine Steuerung oder VLA mit passenden Roboterzuständen und Aktionsdaten |
Eine Vision Language Action-Architektur ergänzt die Ausgabe von Aktionen. Bilder mit Textantworten allein enthalten noch keine zugehörigen Motorbewegungen. Im SO-101-Projekt kannst du Wahrnehmung, Steuerung und die mechanische Aufgabe zusammen betrachten.
Deine kleine Aufgabe: Schreibe drei Fragen zu einem eigenen Foto: eine zu Gegenständen, eine zu ihrer Position und eine zu etwas, das unsichtbar bleibt. Notiere jeweils eine am Bild geprüfte Antwort. Die dritte Antwort darf ausdrücklich «Aus dem Bild nicht feststellbar» sein. Genau solche Grenzen werden später Teil deiner Trainingsdaten.
Berechne einen echten Lernschritt und entdecke, warum ein kleiner Trainingsfehler täuschen kann.
Quellen & weiterführende Dokumentation
Damit kannst du weiterdenken.
-
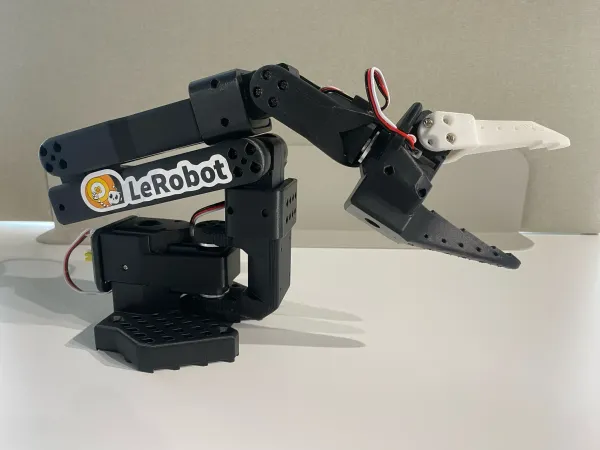
SO-101 Roboterarm (LeRobot)
The Robot Studio / SO-ARM100 contributors · Apache-2.0
Zwei selbst aufgebaute Arme, eine Bewegung: Entdecke, wie der SO-101 mit LeRobot aus vorgemachten Griffen lernen kann.
Mit interaktivem Beispiel · 2 Videos
-
Einen eigenen KI-Agenten verstehen und aufsetzen
Was verändert sich, wenn ein Sprachmodell Werkzeuge benutzen kann?
Mit interaktivem Beispiel · 2 Videos

Das hängt zusammen.
- Training Beispiele + Zielantworten → Angepasste Gewichte
So lernt ein Modell
Verändere echte Gewichte im Browser. Verfolge Vorhersage, Loss und Gradienten – und teste, ob das Gelernte auch bei neuen Bildern funktioniert.
20 Min. Einstieg - OCR Bild mit Schrift → Bearbeitbarer Text
Text aus Bildern lesen
Ein Foto wird zu Text, den du kopieren, durchsuchen oder vorlesen lassen kannst.
4 Min. Einstieg - Fine-Tuning Vortrainiertes VLM + eigene Beispiele → Adapter + Vergleich auf neuen Bildern
Ein VLM mit eigenen Bildern anpassen
Eine konkrete Aufgabe, saubere Bilddaten und ein messbarer Vergleich: Bereite deinen ersten LoRA-Versuch vor – mit einem herunterladbaren Python-Lernpaket.
25 Min. Einstieg
Aktuelles zu VLM
Weitere Beiträge suchen-
Vom Bild zur Stimme: drei Aufgaben, ein Projekt
OCR, visuelle Sprachmodelle und TTS helfen bei unterschiedlichen Aufgaben. So findest du den passenden Einstieg.