Was sieht eine KI auf deinem Foto?
Frag ein echtes Bildmodell direkt im Browser, prüfe seine Antwort am Foto und lerne die drei Dinge, die jede weitere Erklärung tragen. Ohne Formeln, in fünf Minuten.
Zuerst ausprobieren
Stell dem Modell eine Frage zum Werkstattfoto, oder wähle ein eigenes Foto. Das Modell rechnet in deinem Browser. Es ist absichtlich klein: schnell genug zum Ausprobieren, und seine Fehler sind lehrreich.
Frag ein Bildmodell, direkt in deinem Browser.
SmolVLM-256M-Instruct ist ein kleines, offenes Bild-Sprach-Modell. Es wird einmal in deinen Browser geladen (rund 250 MB, danach im Browser-Cache) und rechnet dort. Dein Foto verlässt dein Gerät nicht. Das Modell versteht Englisch; die Fragen sind deshalb englisch.
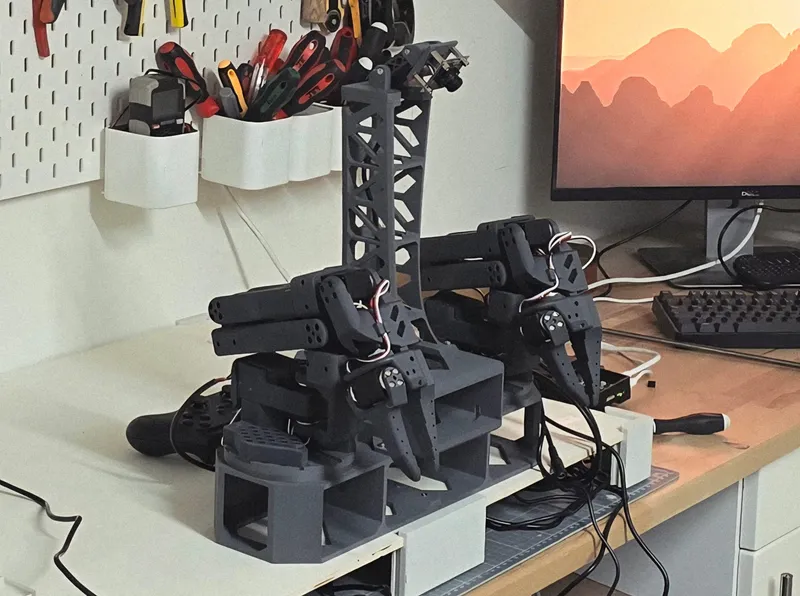
So antwortete das Modell am 7. September 2026 auf dieses Foto
| Frage | Antwort des Modells | Am Foto prüfbar? |
|---|---|---|
| What objects are visible? | Jars, tools, and a monitor. | Ja: Behälter, Werkzeuge und ein Bildschirm sind sichtbar. Die Roboterarme fehlen in der Antwort. |
| Is the robot working? | Yes. | Nein: Ob Motoren, Strom und Software laufen, zeigt ein Standbild nicht. Die Antwort behauptet mehr, als das Bild belegt. |
| Which board is visible? Answer with one label: arduino_uno, raspberry_pi, unknown. | The board is an arduino uno. | Nein: Ein Arduino ist auf dem Foto nicht zu erkennen. Das Modell wählt eine plausible statt einer belegten Antwort; «unknown» wäre ehrlich gewesen. |
Echte Modellausgabe, aber ein sehr kleines Modell mit stark komprimierten Gewichten, ohne Bildaufteilung und mit höchstens 48 Antwort-Token. Grössere Modelle antworten anders, auch falsch. Die Modellrevision ist festgehalten: SmolVLM-256M-Instruct, 7e3e67e, ausgeführt mit Transformers.js.
Probiere es aus: Frag «What objects are visible?» und vergleiche die Antwort mit dem Foto. Frag dann «Is the robot working?». Überlege vor der Antwort: Kann ein Standbild das überhaupt zeigen?
Drei Dinge, die du dir merken kannst
1. Das Modell sieht Zahlen, kein Bild. Bevor irgendetwas «erkannt» wird, wird das Foto in ein festes Raster aus Farbwerten gebracht. Deine Frage wird in kleine Textstücke zerlegt. Beides sind Zahlenreihen. Wie aus diesen Zahlen Merkmale werden, zeigt Teil 1 Schritt für Schritt.
2. Die Antwort wird berechnet, nicht nachgeschlagen. Das Modell hat vorher in einem Training gelernte Einstellungen, seine Gewichte. Beim Antworten benutzt es diese Gewichte nur. Du kannst hundert Fragen stellen, das Modell verändert sich dabei nicht. Was ein Training tatsächlich verändert, rechnest du in Teil 2 selbst nach.
3. Flüssig heisst nicht belegt. Auf «Is the robot working?» antwortet das Modell mit «Yes.» Das Foto zeigt einen Aufbau, keine Bewegung, keinen Strom, keine Software. Die Antwort klingt sicher und ist trotzdem nicht am Bild prüfbar. Auf die Frage nach der Platine nennt es einen Arduino, der nicht zu sehen ist. Genau solche Antworten sind der Grund, warum man ein Modell für eine eigene Aufgabe später an eigenen, geprüften Beispielen misst und bei Bedarf anpasst: Teil 3.
Das Modell antwortet «Yes.» auf «Is the robot working?». Was weisst du jetzt?
Erklärung ansehen
Bildmodelle erzeugen Text, der zu Bild und Frage passt. Ob der Text stimmt, entscheidet nicht die Flüssigkeit der Antwort, sondern dein Vergleich mit dem Foto.
Deine kleine Aufgabe: Wähle ein eigenes Foto und stelle drei Fragen: eine zu Gegenständen, eine zur Position, eine zu etwas, das im Bild unsichtbar bleibt. Notiere zu jeder Antwort: am Foto belegt, plausibel, oder nicht feststellbar. Diese Notizen brauchst du in Teil 1 wieder.
Das kannst du jetzt
- Du hast ein echtes Bildmodell befragt und seine Antwort am Foto geprüft.
- Du kannst erklären, warum Fragen ein Modell nicht verändern.
- Du erkennst eine Antwort, die mehr behauptet, als das Bild zeigt.
Pixel, Bildmerkmale, Projektor und Text-Token an einem konkreten Modell, mit dem Werkstattfoto zum Selbstuntersuchen.
Quellen & weiterführende Dokumentation
Das hängt zusammen.
- VLM Bild + Frage → Textantwort
Bilder verstehen
Was passiert zwischen Foto und Antwort? Verfolge Pixel, Bildmerkmale und Sprache durch ein VLM – und finde heraus, was es dabei wirklich lernt.
15 Min. Einstieg - Training Beispiele + Zielantworten → Angepasste Gewichte
So lernt ein Modell
Verändere echte Gewichte im Browser. Verfolge Vorhersage, Loss und Gradienten – und teste, ob das Gelernte auch bei neuen Bildern funktioniert.
20 Min. Einstieg - OCR Bild mit Schrift → Bearbeitbarer Text
Text aus Bildern lesen
Ein Foto wird zu Text, den du kopieren, durchsuchen oder vorlesen lassen kannst.
4 Min. Einstieg